Осенью 2026 года БПЛА повредили в России три дата-центра «Яндекса». Это инфраструктура одной компании, но как так получилось, что проблемы в её работе сказались на доступности множества сторонних сайтов, приложений и не только?
В этом нет ничего удивительного. Так устроены облачные платформы. Для «Яндекса» дата-центры — не только собственная потребность, но и отдельный бизнес под названием Yandex Cloud. У него есть много разных клиентов — от крупных компаний до малого бизнеса. Вырисовывается понятная цепочка: проблемы у Yandex Cloud → проблемы у его клиентов → проблемы у тех, кто полагается на этих клиентов.
Сейчас появился наглядный пример того, как много в интернете и современной жизни зависит от облака. Подходящее время, чтобы разобраться, как оно работает — и почему не всегда удаётся избежать последствий аварий. Сначала посмотрим на устройство облачных платформ в целом, а потом вернёмся именно к инциденту с Yandex Cloud.
Почему бизнес выбирает облако
Если вы запускаете сайт, приложение, сервис — что угодно, чем люди пользуются через интернет, — вам нужно где-то хранить код и данные. Есть три основных варианта: обслуживать собственные серверы, арендовать готовые серверы или же воспользоваться облачной платформой.
- В первом случае придётся самостоятельно купить оборудование, найти для него место, обеспечить бесперебойное питание и охлаждение, обслуживать сервер и следить за его работоспособностью.
- Аренда упрощает процесс. Оборудование находится у хостинг-провайдера, который отвечает за его обслуживание на аппаратном уровне. Вам остаётся заниматься софтом: программами, данными и настройками сервера.
Вариант с арендой уже выглядит в целом просто, да и это достаточно распространённая практика. Но есть нюанс: сложно заранее угадать, сколько мощностей понадобится.
Допустим, вы запускаете интернет-магазин. Что если вы арендовали небольшое количество оборудования, а сайт внезапно стал вирусным? Нахлынуло много посетителей, мощностей не хватило, серверы легли. Или наоборот вы арендовали серверов с запасом, а аудитории так и нет? Тогда приходится платить за простаивающее оборудование.
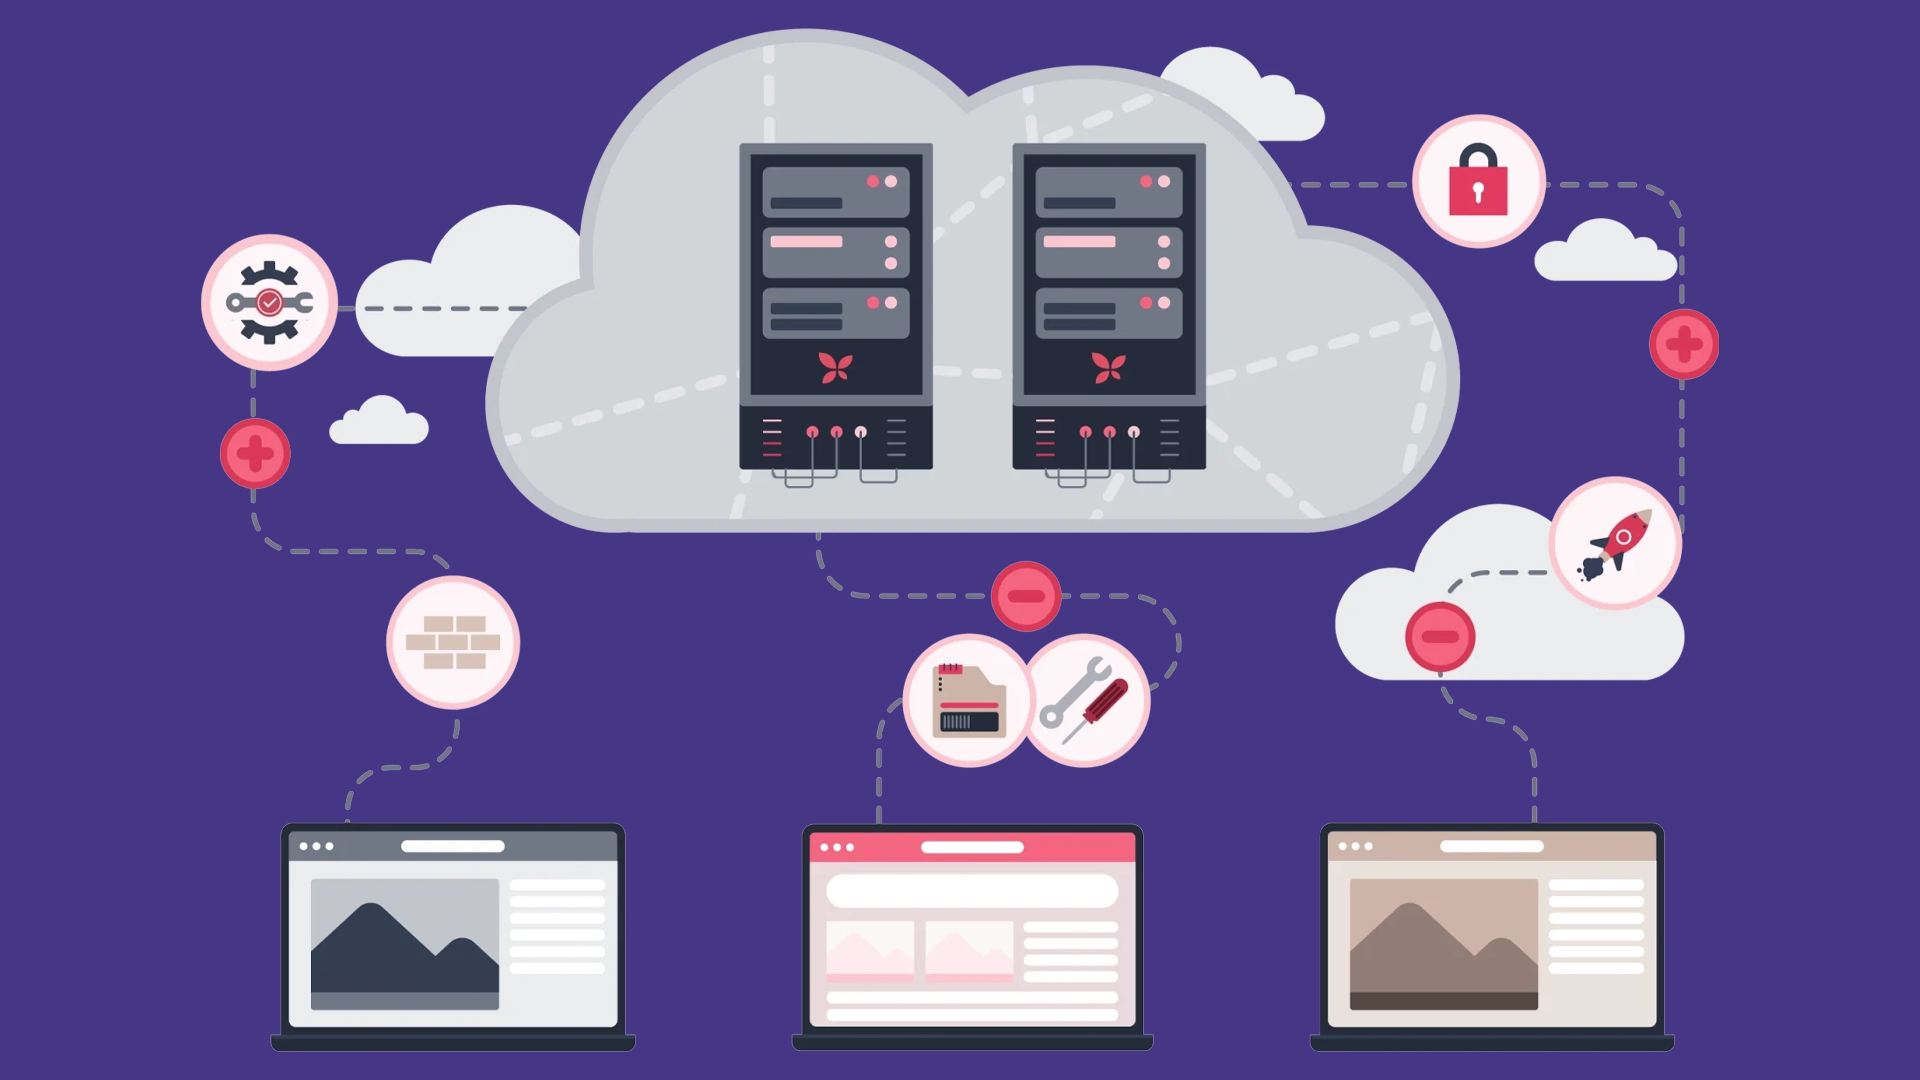
Облачные платформы помогают решить эти проблемы. Главное отличие облака — гибкость. Здесь вместо аренды конкретного сервера вы получаете доступ к вычислительным ресурсам целой платформы: при необходимости вы можете взять себе её мощности в любую минуту — конечно, есть нюансы, но о них немного позже. Вы работаете с целой инфраструктурой, без привязки к определённым серверам. Это быстрее, проще и так можно намного эффективнее расширять свою систему — например, если начинаете с малого, а потом набираете аудиторию. Если всё правильно настроить, проблем с увеличением мощностей не будет.
Зачастую платить нужно только за ресурсы, которые вы используете в конкретный момент — если мощности простаивают, платить за них не придётся. Но точный механизм зависит от конкретного провайдера, и в эти подробности мы не будем углубляться.
Этот процесс, когда вы расширяете свои мощности, называется масштабированием. Это не работает само по себе, но после грамотной настройки вы получаете автомасштабирование — ещё одно важное преимущество облачных вычислений. Особенно в сочетании с моделью оплаты за облако, описанной в абзаце выше.
С автомасштабированием платформа сможет самостоятельно добавлять вычислительные ресурсы при росте нагрузки и сокращать их, когда посетителей становится меньше. Например, интернет-магазин сможет запросить больше мощностей во время распродажи, а после её окончания вернуться к обычному объёму.
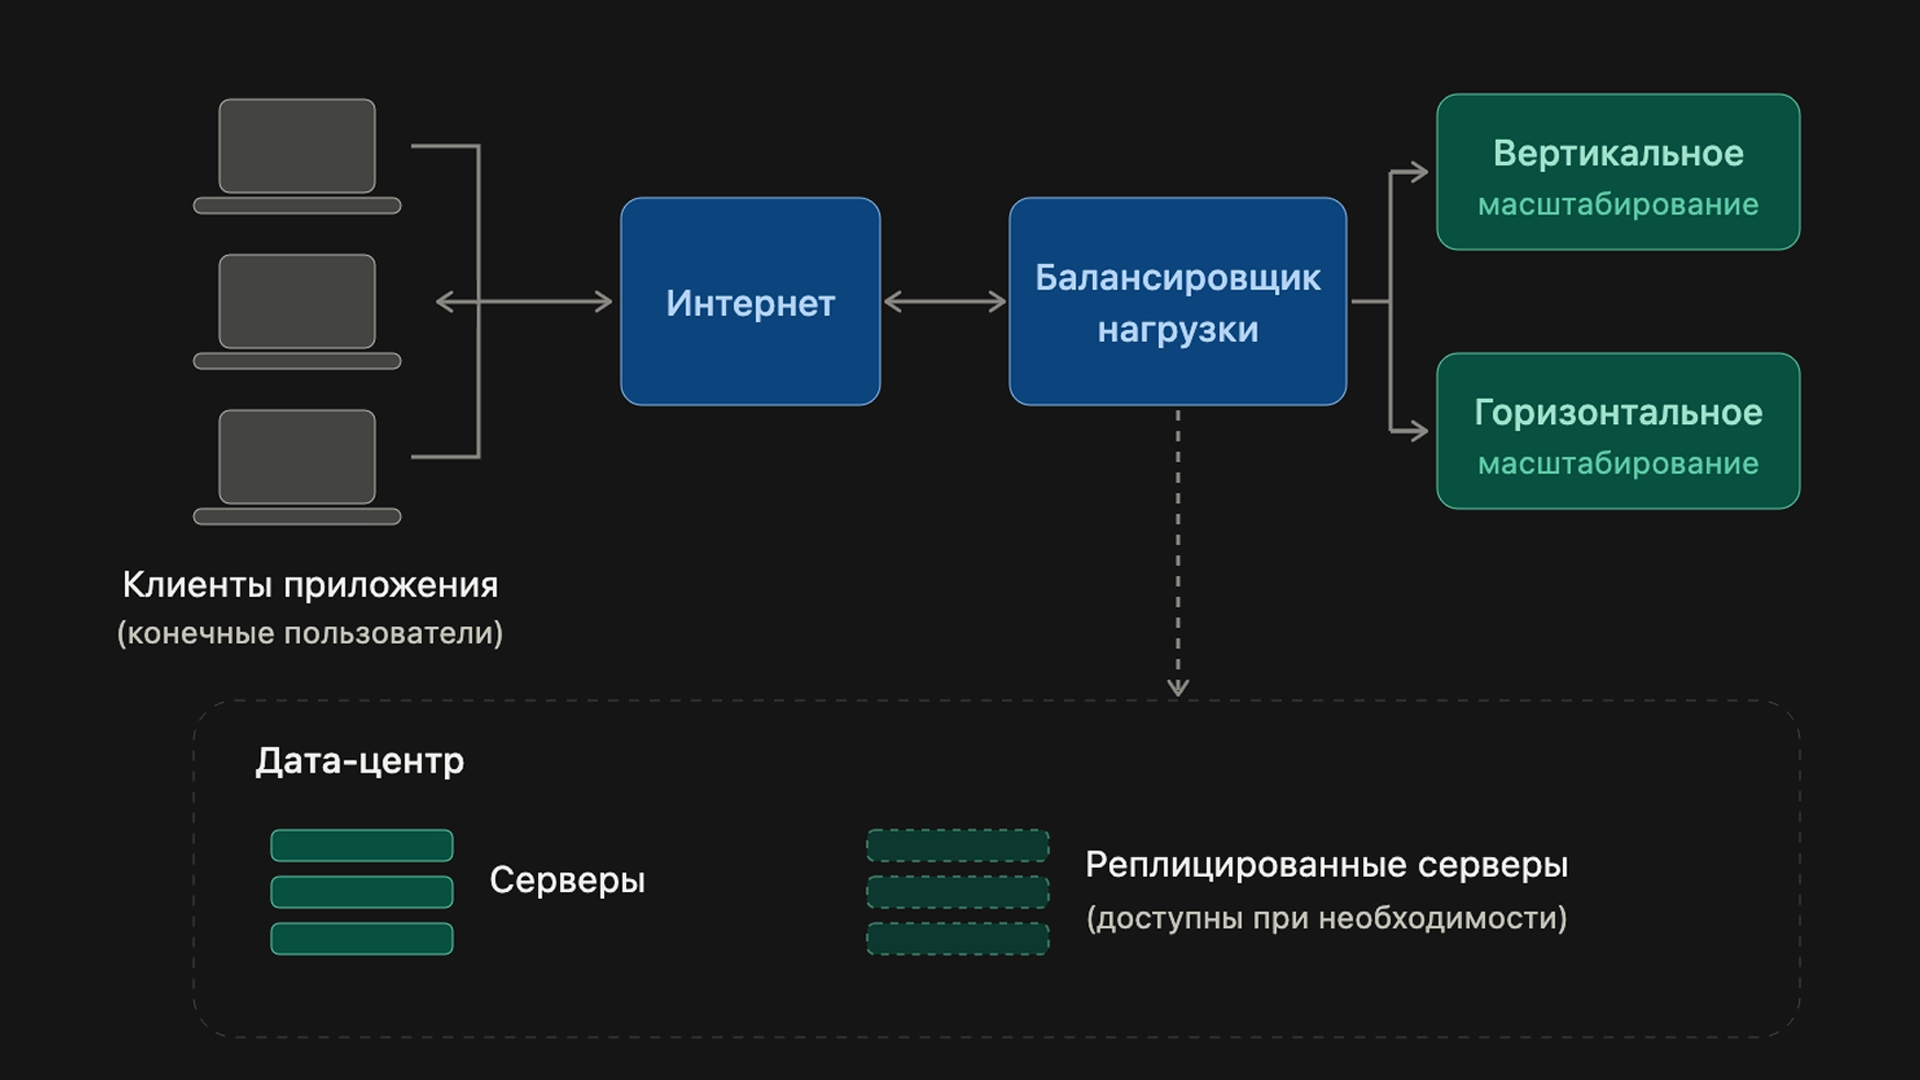
В итоге не нужно всегда держать активными серверы под пиковую нагрузку и вручную увеличивать мощность при наплыве пользователей. Главное, чтобы у провайдера были свободные ресурсы. Облако не безлимитно и не принимает все решения по архитектуре за клиента.
Облако — не огромный компьютер, а куча серверов, систем хранения данных и сетевого оборудования, часто расположенных в разных зданиях. Платформа распределяет эти ресурсы между клиентами и предоставляет их в удобном виде: например, как виртуальные серверы, хранилища или управляемые базы данных.
Звучит хорошо, но это не панацея. В долгосрочной перспективе собственные серверы могут оказаться выгоднее, а при использовании облака клиент зависит от провайдера. Если у облака возникнут проблемы, они могут затронуть и клиентские сервисы. В октябре пользователи Рунета убедились в этом на личном опыте.
Но это не значит, что любой сбой обязательно приведёт к остановке сайта: многое зависит от того, как устроена инфраструктура и предусмотрены ли в ней механизмы отказоустойчивости.
Как устроены облачные вычисления
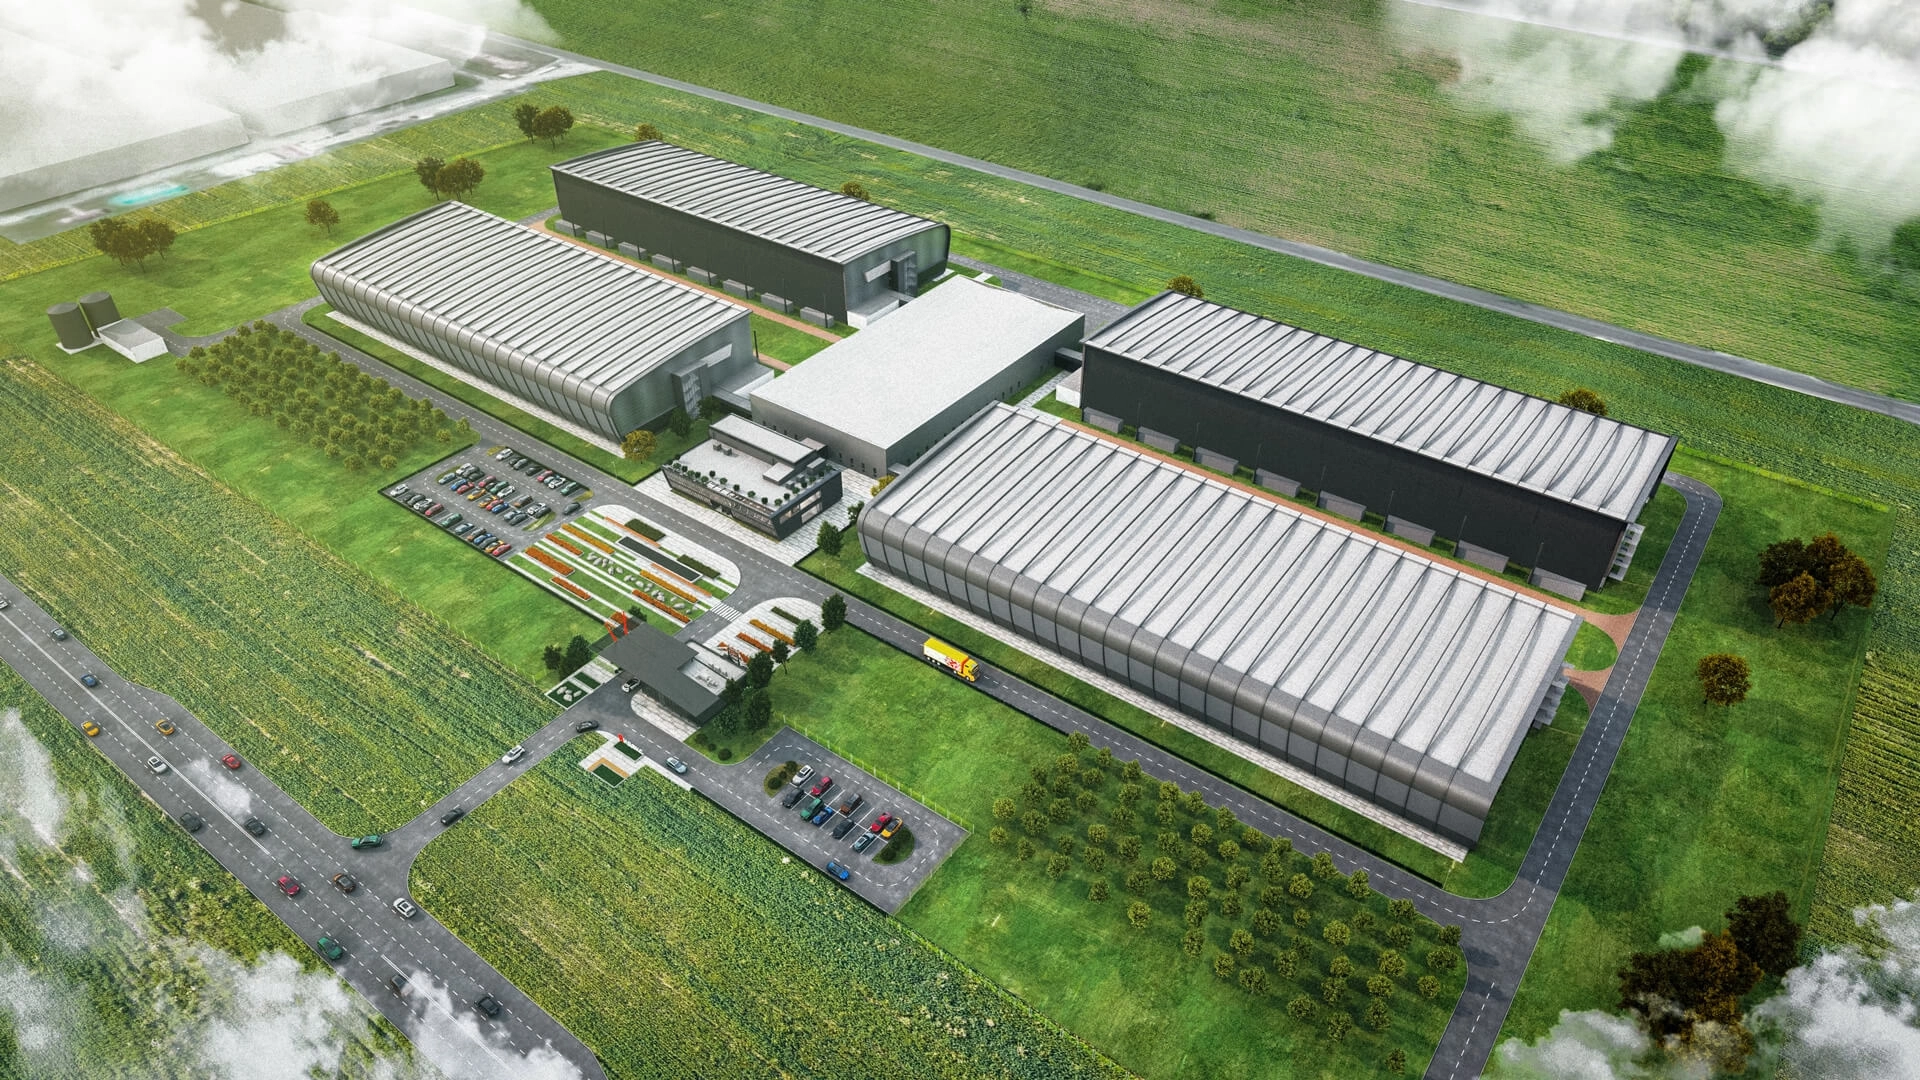
Облако не находится в каком-то абстрактном пространстве в интернете. Физически оно представляет собой инфраструктуру, которой управляет провайдер — например, Yandex Cloud или Selectel. Она состоит из центров обработки данных (ЦОД, или дата-центр) — специальных зданий, заполненных серверами, системами хранения данных и сетевым оборудованием.
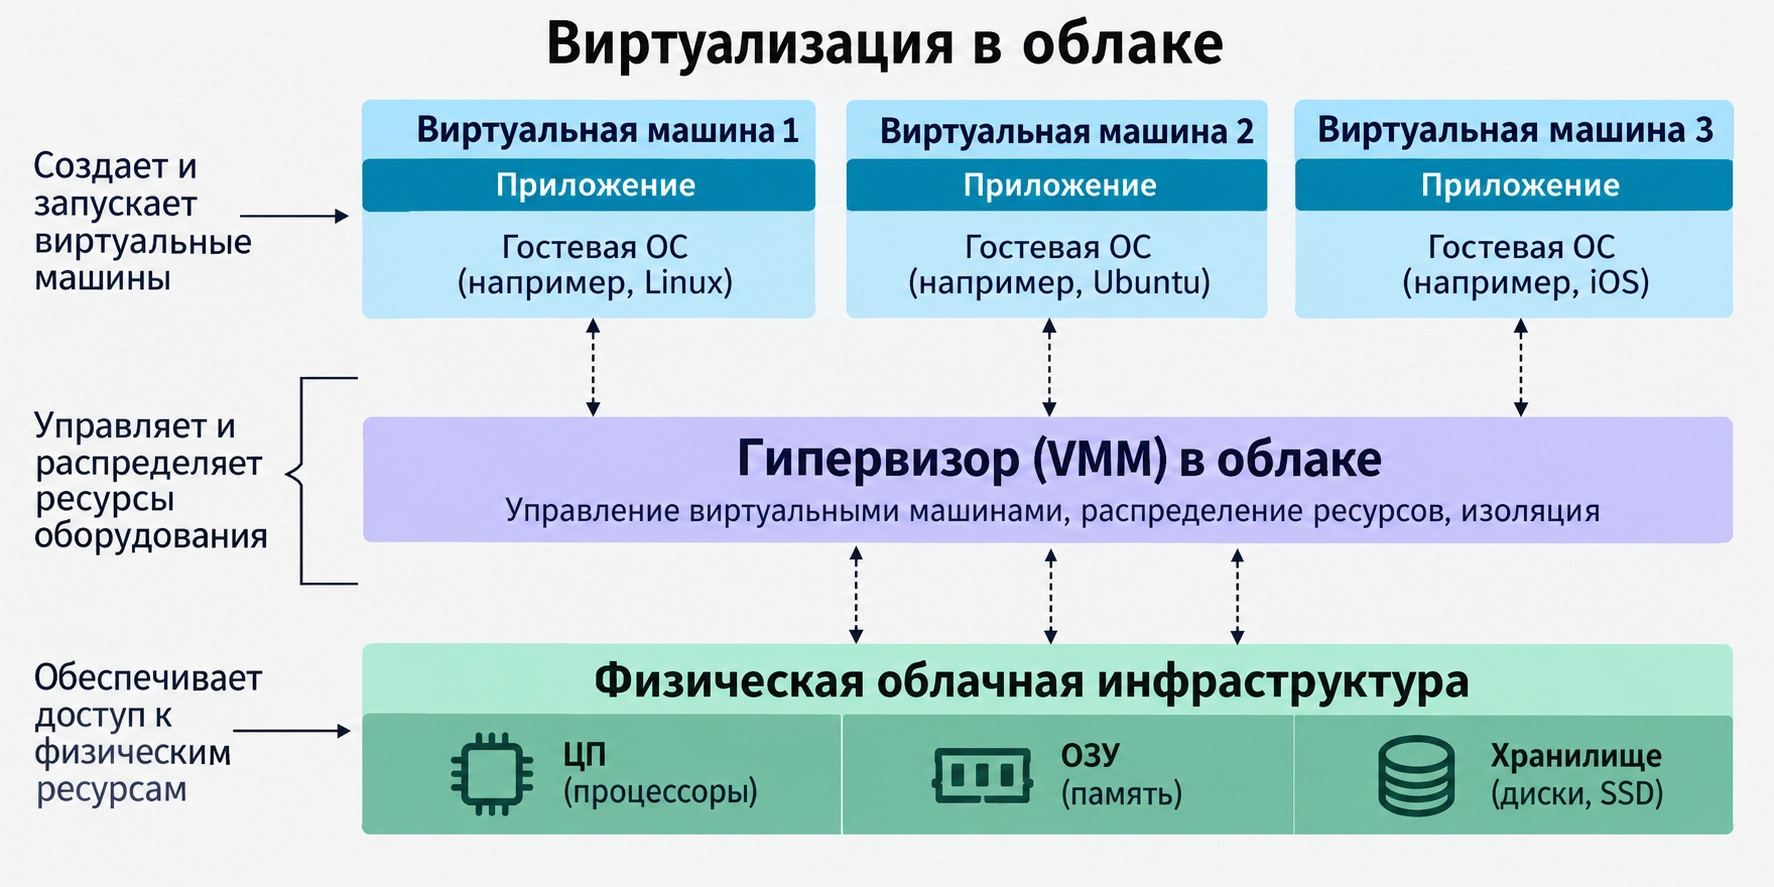
Клиенты облака пользуются не самим физическим оборудованием, а представляемыми им вычислительными ресурсами. Одни и те же серверы обслуживают разных клиентов — благодаря виртуализации. На одном сервере могут сосуществовать десятки и даже сотни виртуальных машин — изолированных программных сред, каждая из которых ведёт себя во многом как отдельный компьютер.
Одна железка = много пользователей. Виртуальные компьютеры используют общие физические ресурсы, но разделены программно — их данные не пересекаются. Ваш условный интернет-магазин работает на том же железе, что приложения и сервисы других клиентов.
Облачные платформы предлагают не только сырое оборудование в виде виртуальных серверов, но и разные уровни услуг с говорящими названиями:
- IaaS — Infrastructure-as-a-Service, инфраструктура-как-услуга. По сути, это та же аренда вычислительной инфраструктуры: виртуальных серверов, сетей и дисков. Провайдер обслуживает физическое оборудование и базовую платформу, а клиент управляет операционной системой, устанавливает программы и отвечает за настройку своего приложения.
- PaaS — Platform-as-a-Service, платформа-как-услуга. Клиент получает готовую среду для запуска приложений. Провайдер берёт на себя больше забот об операционной системе и инфраструктуре, поэтому разработчику не нужно управлять каждым сервером самостоятельно.
- SaaS — Software-as-a-Service, ПО-как-услуга. Клиент получает готовую программу через интернет. Устанавливать и обслуживать серверы ему не нужно.
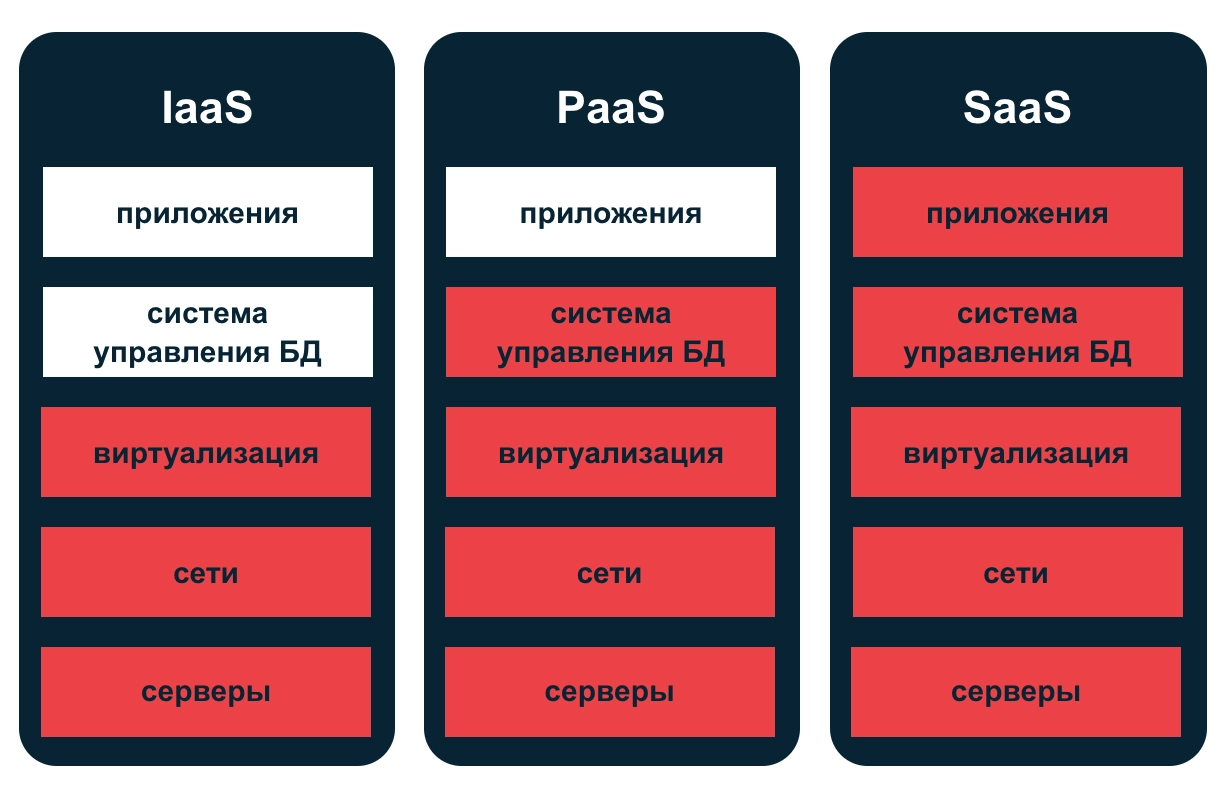
В итоге облачные вычисления — это не просто аренда серверов. Провайдер может предложить клиенту целый набор услуг: от виртуальных машин и хранилищ до управляемых баз данных и готовых программных платформ вроде «Google Документов» или «Яндекс Диска». Облачными вычислениями пользуются и обычные люди, не только бизнес.
Вся эта инфраструктура распределяется по дата-центрам. У больших компаний их много: например, у американского гиганта AWS — сотни по всему миру. Здесь проявляется гибкость облака — платформа делится на географические области. Для удобства управления и организации работы такие площадки объединяют в регионы и зоны доступности.
Регион — это географическая область, а зона доступности — изолированная часть инфраструктуры внутри неё.
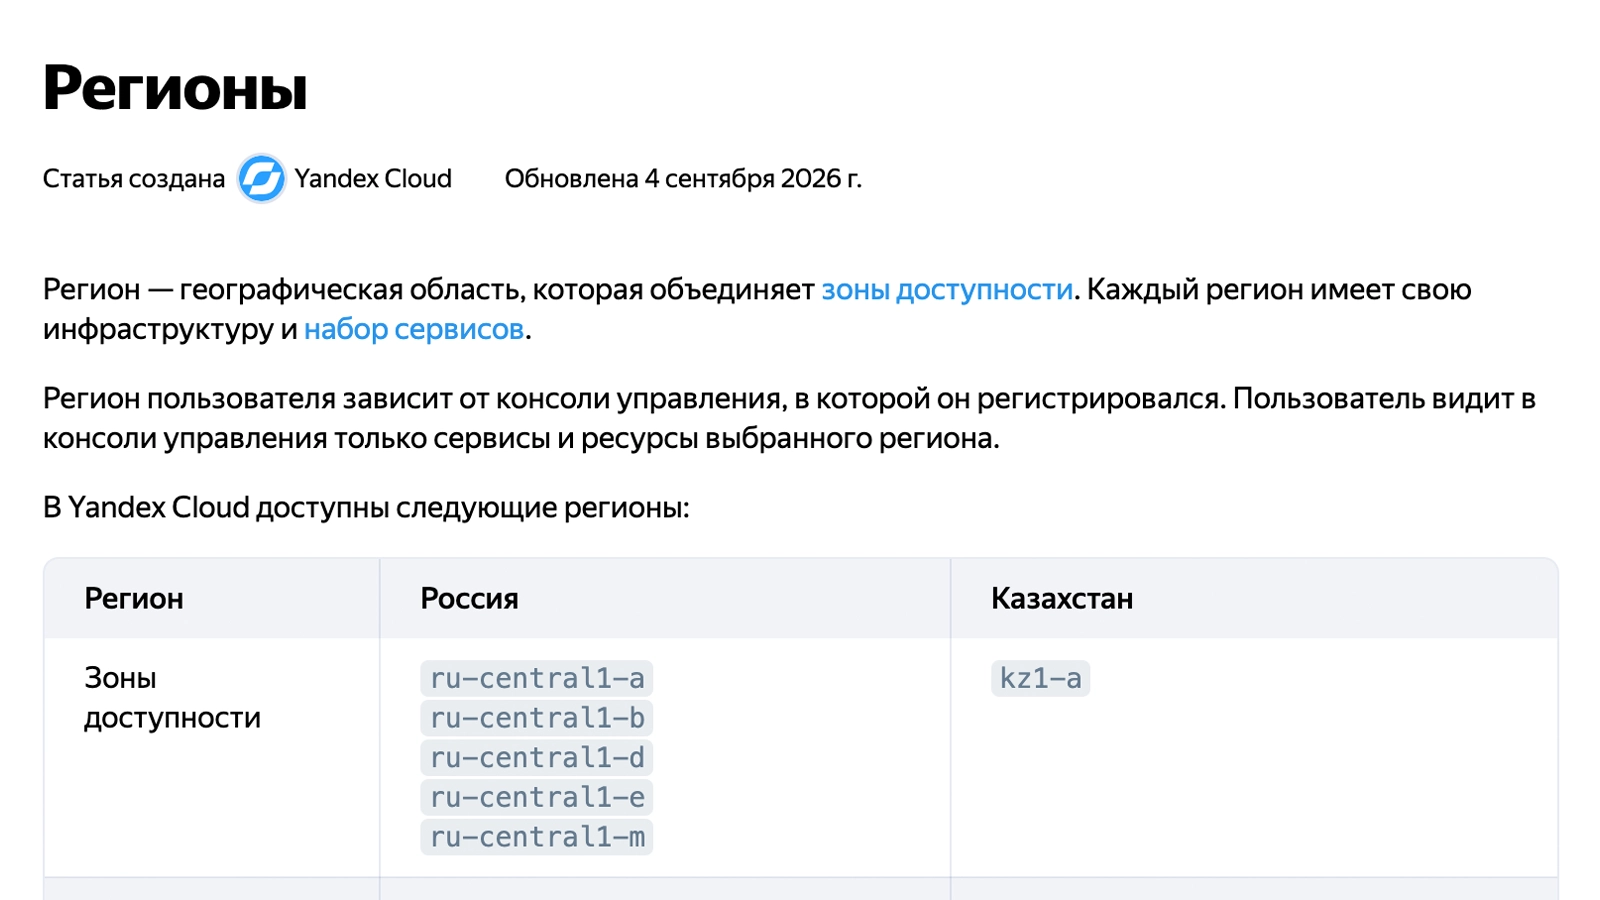
Если сервис размещён сразу в нескольких зонах, он может продолжить работу при отказе одной из них. Но для этого приложение должно быть заранее настроено на работу в нескольких зонах, а необходимые данные и свободные ресурсы должны быть доступны в оставшейся инфраструктуре. Просто создать сервер в одной зоне и надеяться, что облако само перенесёт его в другую, недостаточно.
Организация такой схемы требует дополнительных ресурсов и нередко заметно увеличивает стоимость инфраструктуры. Поэтому архитектуру выбирают с учётом того, насколько критичен простой и сколько бизнес готов потратить на повышение надёжности. Мультизональностью облака пользуются не все клиенты.
Как облачная платформа переживает аварии
Дата-центры сразу проецируют с расчётом на возможные неполадки: используют резервные источники питания, системы охлаждения, противопожарную защиту, контроль физического доступа и другие инженерные средства. Первый шаг — обслуживание инфраструктуры, чтобы снизить вероятность аварий и ограничить их последствия.
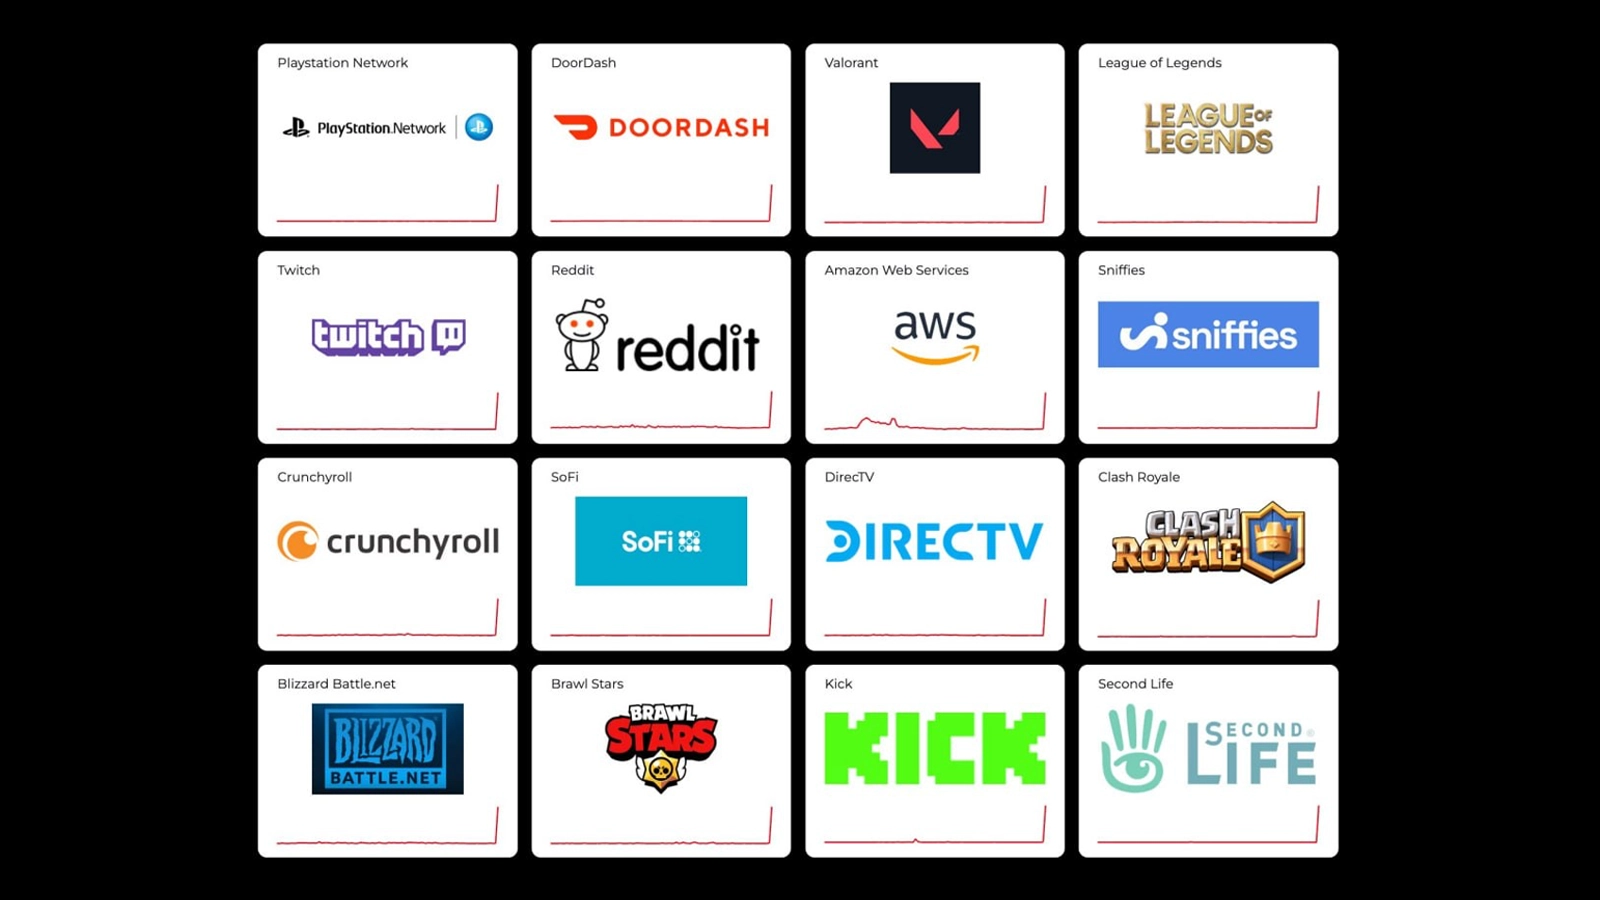
Конечно, полностью исключить сбои невозможно. Может выйти из строя оборудование, пропасть электропитание или нарушиться работа сети. Иногда авария затрагивает целый дата-центр, а в тяжёлых случаях — несколько площадок. Это норма, и такие неполадки бывают у всех. Из-за сбоя того же AWS может «лечь половина интернета» — от Twitch и Reddit до видеоигровых серверов.
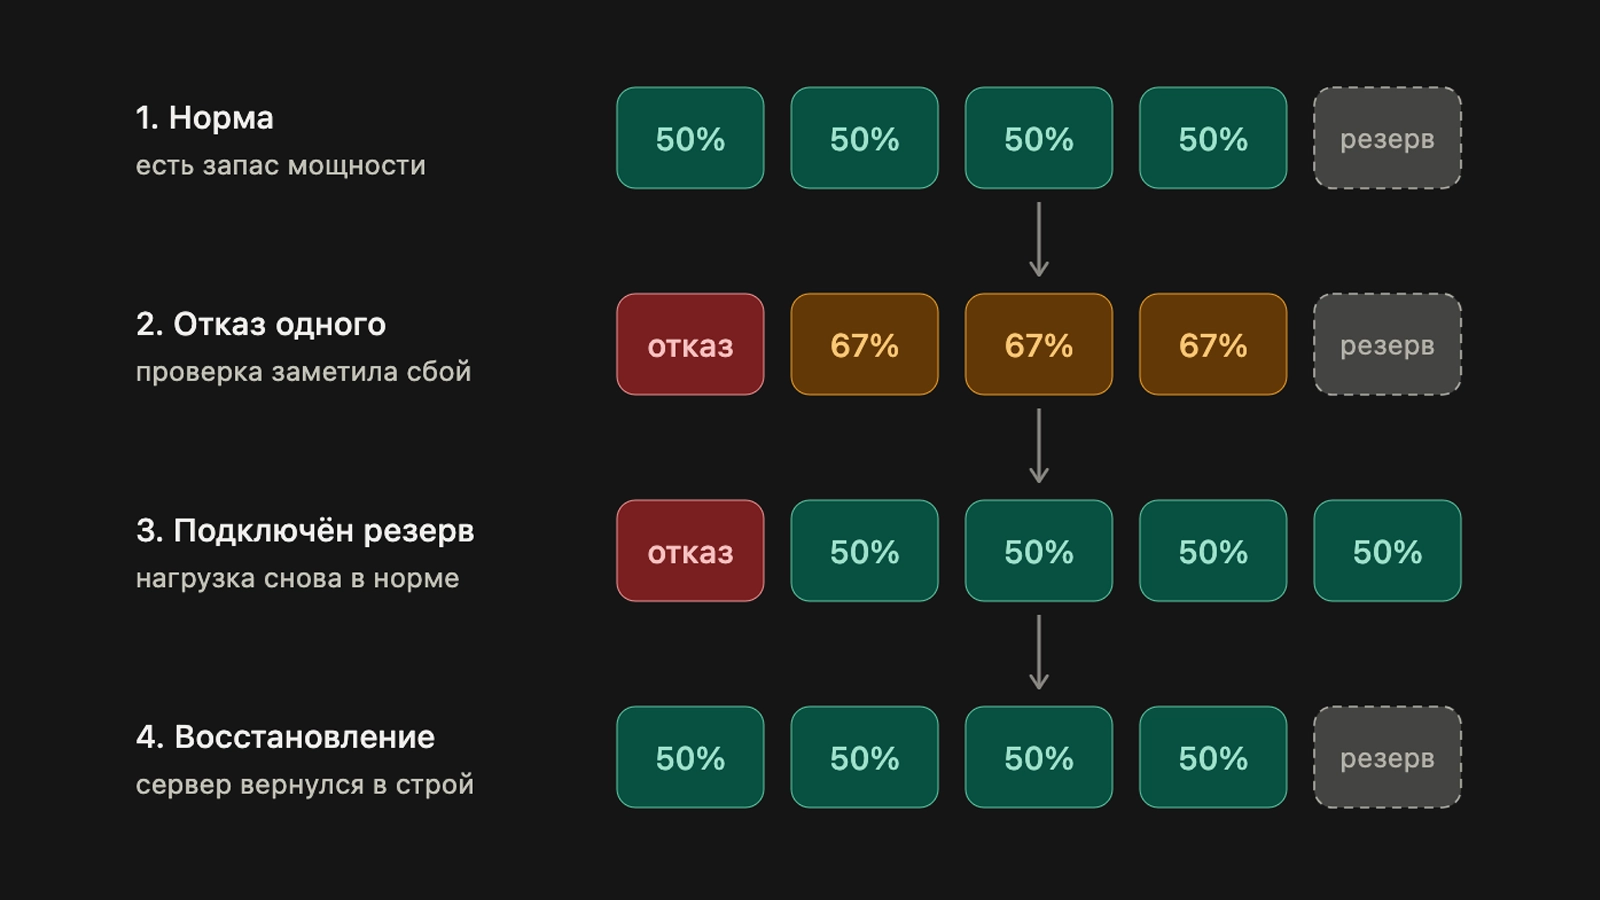
В такой ситуации и проявляются особенности облака — конкретно его возможность задействовать ресурсы другой зоны доступности. Если сервис заранее подготовлен к этому, нагрузку можно переключить на другое, работающее, оборудование. Это не обязательно происходит автоматически и не гарантирует, что пользователи ничего не заметят: в другой зоне должны быть свободные мощности, доступные данные и все необходимые компоненты приложения.
Отказоустойчивость облака — это способность облачной инфраструктуры продолжать работу даже при выходе из строя отдельных её компонентов: серверов, жёстких дисков, сетевых кабелей или целых дата-центров.
Клиент тоже может подготовиться к возможному сбою. Например, запустить несколько экземпляров приложения, распределить их по независимым зонам, настроить резервирование данных и переключение трафика. Провайдер предоставляет для этого инфраструктуру и инструменты, но конечная схема зависит от вашего сервиса.
Компоненты своего интернет-магазина вы можете разместить в разных изолированных зонах — копии данных и дополнительные серверы помогают пережить отказы в отдельных зонах доступности.
То же касается и сервисов, которыми пользуются обычные люди. Например, облачное хранилище может поддерживать несколько копий файлов, чтобы отказ отдельного компонента не приводил к потере данных или их недоступности.
Почему аварии всё-таки сказываются на работе
Всё зависит от того, как устроена инфраструктура конкретного сервиса и что именно вышло из строя.
Например, несколько серверов могут зависеть от одной базы данных или общего сетевого компонента. Если этот общий элемент откажет, распределённые серверы окажутся бесполезны. А если авария затронет сразу несколько площадок или общие системы облачной платформы, последствия могут оказаться масштабнее, чем при поломке одного сервера.
И в основном при проектировании рассчёт идёт на то, что откажет только отдельная площадка. Если авария затрагивает несколько зон доступности, ситуация сильно усложняется. Нагрузка на оставшиеся мощности намного сильнее. Может возникнуть каскадный сбой: зона A недоступна → нагрузка переходит в B → B тоже недоступна → запросы A и B перенаправляются в C → C перегружается.
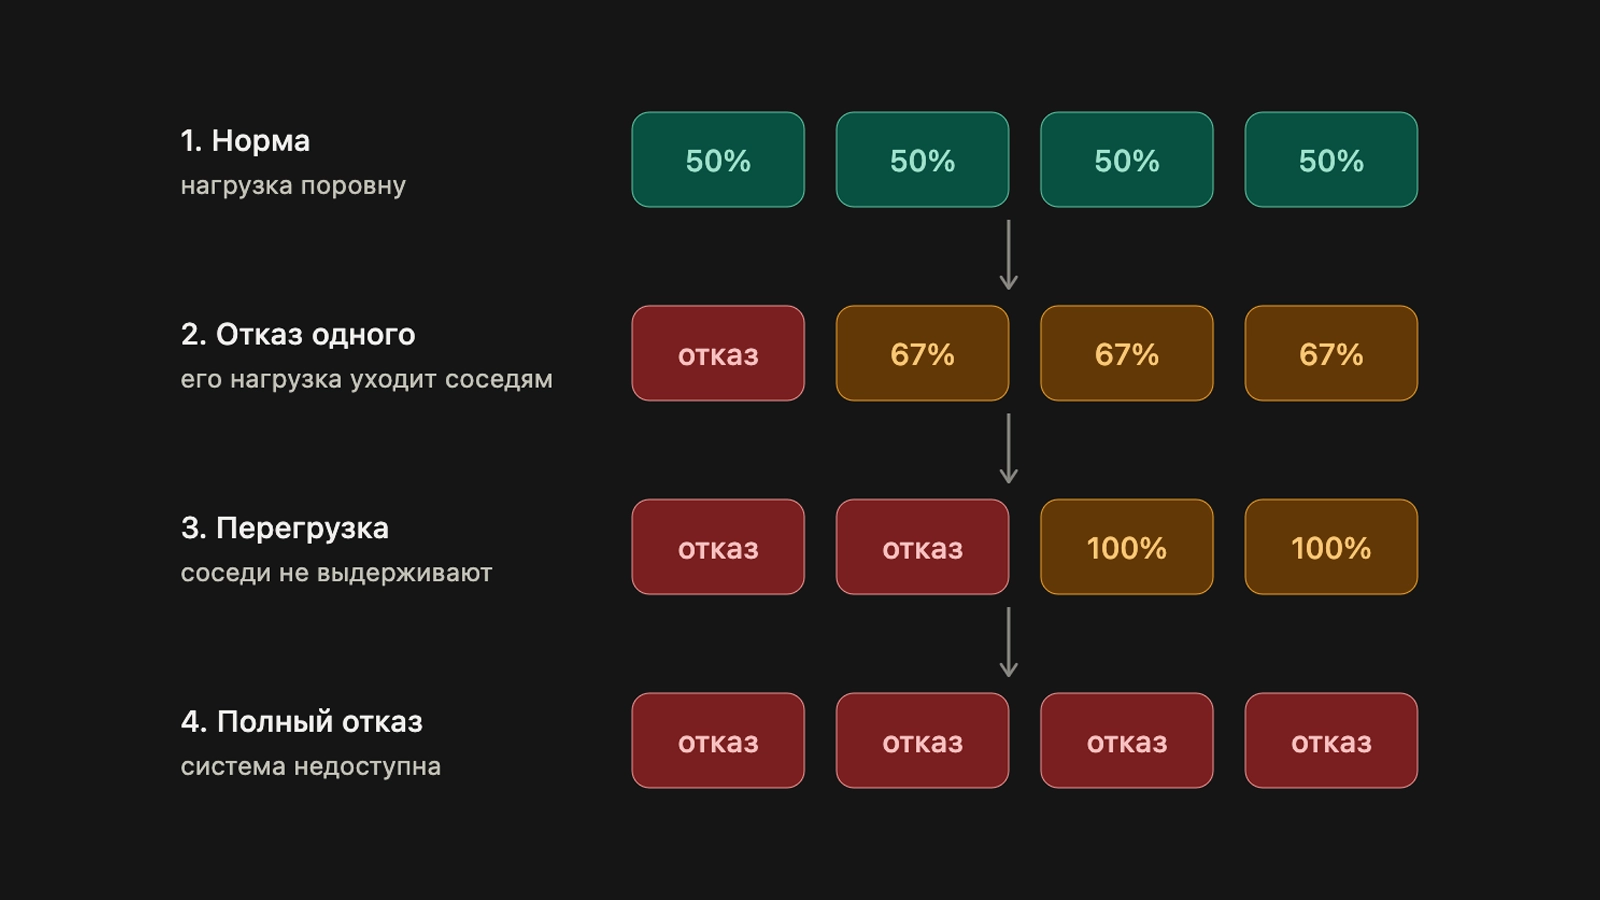
Резервные мощности должны не только существовать, но и быть доступны в момент аварии. Ну и переключение на резерв не поможет, если вместе с основной площадкой недоступны данные или критически важные зависимые элементы.
Могут ли данные пропасть навсегда
Теоретически, могут. Несмотря на все преимущества облаков, данные по-прежнему хранятся на физических носителях. Если с ними что-то случится, данные могут оказаться недоступны. Так что полностью полагаться на облако не стоит.
Но для этого нужно, чтобы пропали сразу все копии данных. Чем больше копий, тем меньше вероятность, что данные безвозвратно исчезнут.
И пока ещё сохраняются проблемы в работе облака, может быть рано делать выводы о том, пропали ли данные. Иногда информация остаётся в сохранности, но бывает временно недоступна из-за проблем с инфраструктурой.
Какие можно сделать выводы после инцидента с Yandex Cloud
В России у Yandex Cloud пять зон доступности, и в октябре после атак две из них — ru-central-1a и ru-central-1b — оказались недоступны. После первой атаки компания переключила нагрузку на другие зоны, но через пару дней проблемы появились и на ЦОД во Владимирской области. Но есть же другие зоны доступности?
Проблема в том, что на оставшиеся мощности могла прийтись слишком большая нагрузка. Тогда мог получиться тот самый каскадный сбой — мультизональность облака упирается в физический потолок свободных мощностей. Ситуацию усугубляет и зависимость одних компонентов от других. Без этого никак, в облаке (и в интернете в целом) всё созависимо.
Опять-таки, ваш условный интернет-магазин может и не работать с Yandex Cloud, но работать с сервисом, который полагается на Yandex Cloud — например, сервис авторизации или платёжный сервис. Так сбой по цепочке добирается и до вас.
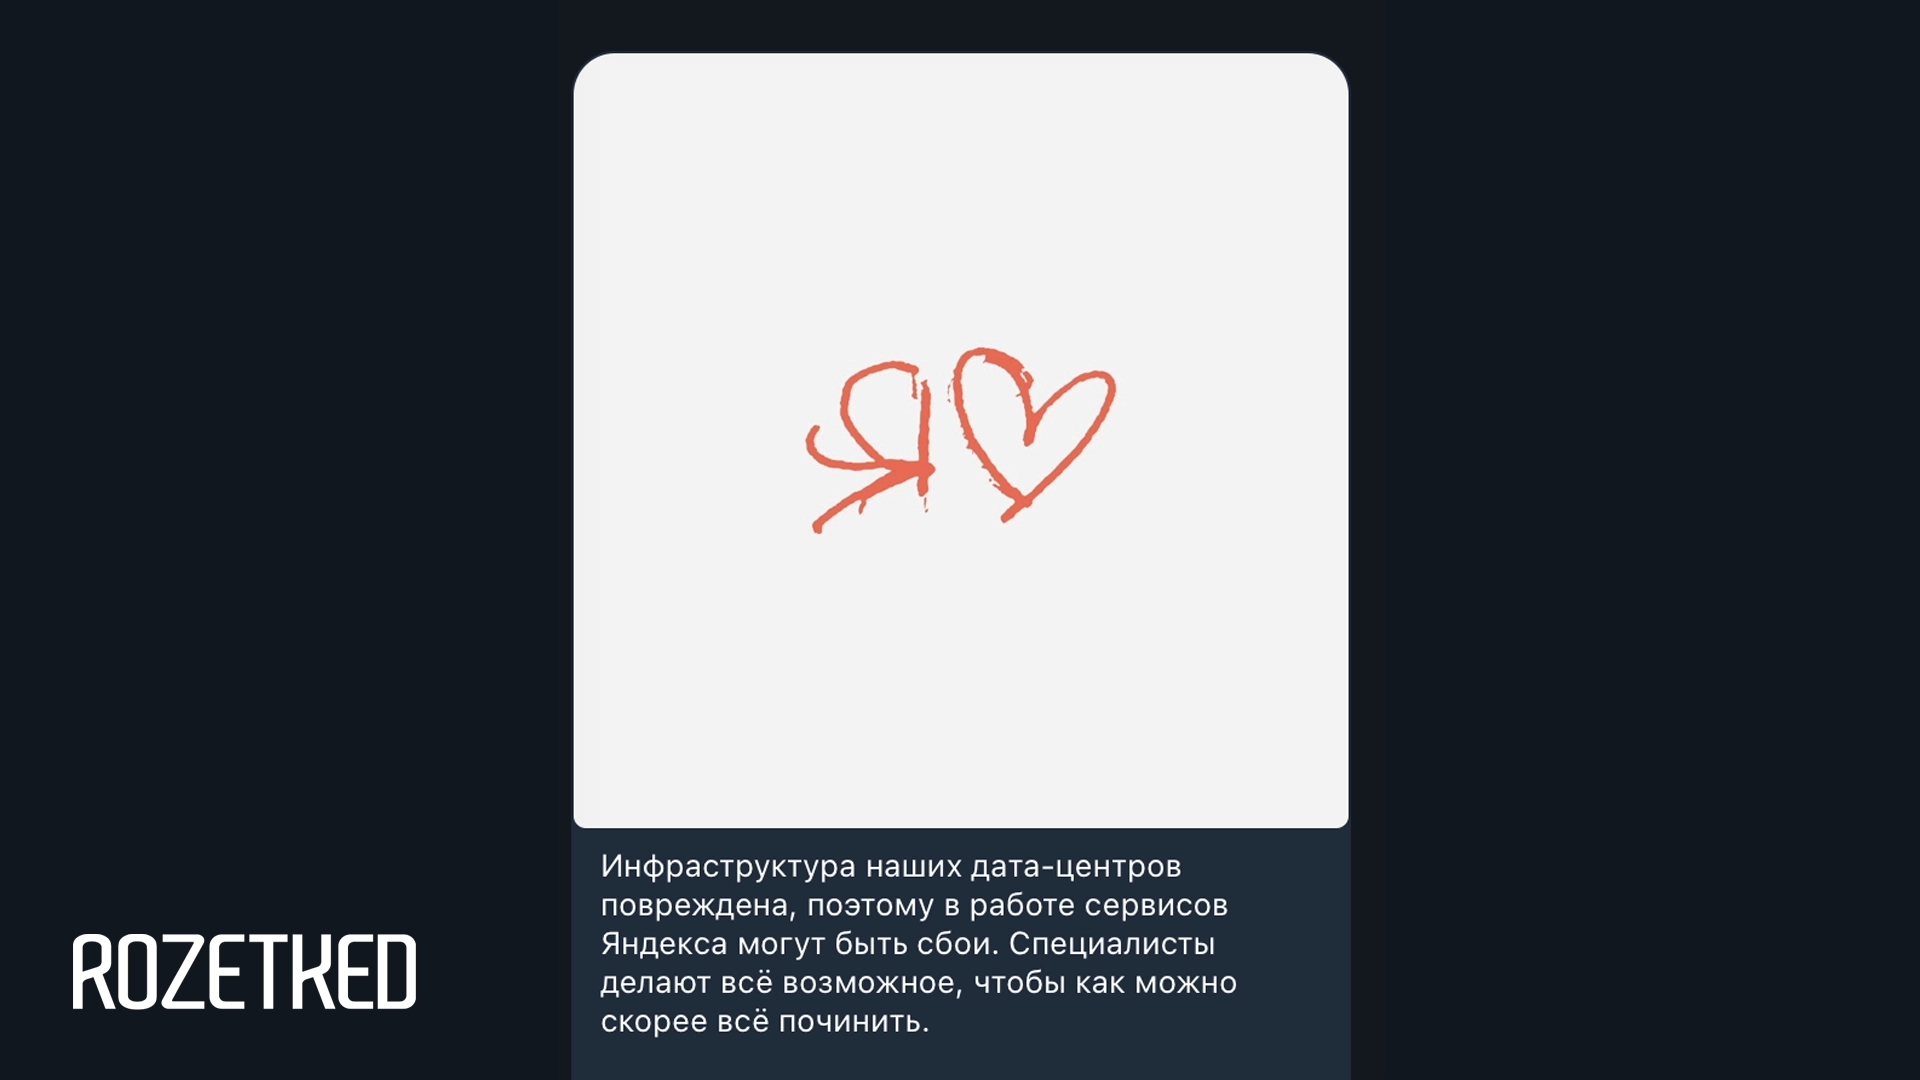
Но официальных подробностей о том, что именно вышло из строя, пока мало. Работы над восстановлением ещё ведутся.
Значит ли это, что облако внезапно оказалось ненадёжным? Нет. Системы защиты в облаке изначально на дают гарантий, что всё продолжит работать, если одновременно выйдут из строя несколько площадок — оставшихся ресурсов может не хватить. Облако не отменяет физические ограничения оборудования.
Ну и многое зависит от того, как клиенты используют облако. Оно избавляет бизнес от необходимости самостоятельно обслуживать физические серверы, но не отменяет заботу о надёжности собственных сервисов. Нужно заранее продумать резервное копирование, распределение нагрузки и план восстановления после аварии.
Если для клиента критичен простой, можно предусмотреть резервную инфраструктуру у другого провайдера или на собственной площадке. Но одного такого резерва недостаточно: необходимо заранее подготовить приложение, обеспечить доступность данных и настроить переключение. Это тоже требует дополнительных затрат.